Atualizado em 01/09/2026
Neste artigo: O que é · Como funciona · Idiomas / PT-BR · vs Whisper · Preço · Como usar · Vale a pena? · FAQ
O Meta Muse Voice Transcribe é o primeiro modelo de percepção de áudio em tempo real da Meta, lançado em 01/09/2026 pelo Meta Superintelligence Labs, com taxa de erro de palavras (WER) de 3,1% no benchmark Artificial Analysis AA-WER Streaming — o melhor resultado entre todos os modelos avaliados até esta data.
Se você busca uma ferramenta para transcrever reuniões automaticamente, calls e podcasts com alta precisão, o Muse Voice Transcribe chega com credenciais robustas: suporta mais de 70 idiomas, diariza até 20 falantes em um único modelo e tem acesso disponível via API. Neste guia completo você vai entender o que é, como funciona, quanto custa e se vale a pena para o seu caso de uso.
1. O que é o Meta Muse Voice Transcribe?
O Meta Muse Voice Transcribe é um modelo de reconhecimento automático de fala (ASR) desenvolvido pelo Meta Superintelligence Labs e lançado no dia 1º de setembro de 2026. Trata-se do primeiro modelo de percepção de áudio em tempo real criado pela Meta, reunindo em uma única arquitetura três capacidades que até então exigiam sistemas separados:
- ASR streaming — transcrição em tempo real conforme o áudio chega, sem esperar o fim da fala
- Diarização de até 20 falantes — identificação automática de quem está falando em cada trecho
- Endpointing inteligente — detecção do fim de cada enunciado para segmentação correta
O resultado é um modelo end-to-end que, segundo a documentação oficial do Meta Research, atingiu WER de 3,1% no benchmark Artificial Analysis AA-WER Streaming — o melhor desempenho entre todos os modelos avaliados no lançamento.
O modelo integra a família “Muse” e o ecossistema Muse Code — a plataforma de IA da Meta para desenvolvedores. Antes mesmo da divulgação pública, o Muse Voice Transcribe já era usado internamente para habilitar o ditado por voz no Meta AI for Mac: basta segurar a tecla Fn no Mac para ativar.
Para quem acompanha o mercado de IAs para transcrever áudio, o lançamento representa uma mudança relevante: em vez de soluções que tratam ASR, diarização e endpointing como módulos separados, a Meta adotou uma abordagem unificada — e os benchmarks confirmam a eficácia da aposta.
2. Como funciona o Meta Muse Voice Transcribe?
A arquitetura do Muse Voice Transcribe combina processamento em streaming com aprendizado por reforço (RL) para equilibrar velocidade e precisão em tempo real. Entenda cada componente:
Chunks de 80ms a 12,5Hz
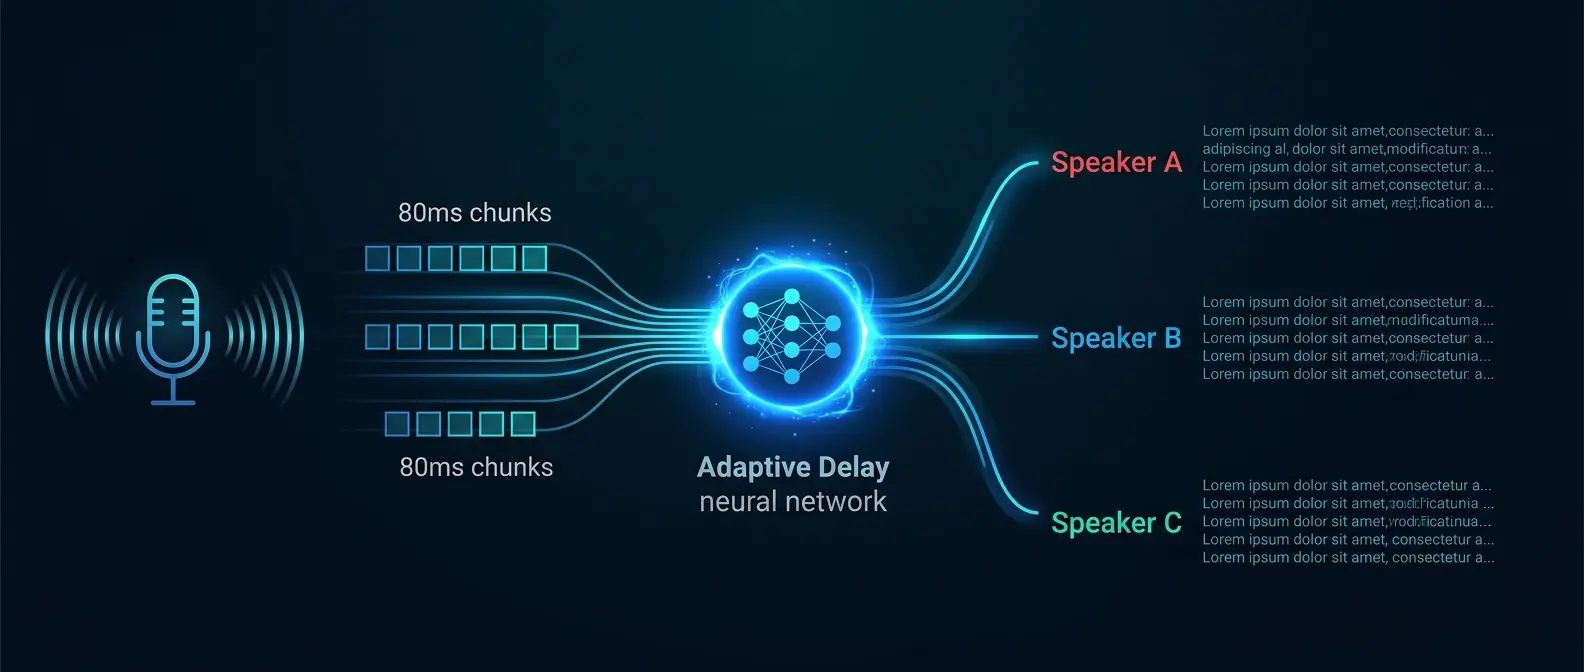
O áudio de entrada é dividido em fragmentos (chunks) de 80 milissegundos, processados a uma taxa de 12,5 Hz — ou seja, 12,5 fragmentos por segundo. Esse cadência é rápida o suficiente para gerar transcrições que parecem ocorrer em tempo real.
Adaptive Delay: a inovação central
O diferencial técnico mais relevante é o adaptive delay, treinado por aprendizado por reforço. Em vez de um atraso fixo para aguardar contexto adicional antes de transcrever cada palavra, o modelo decide dinamicamente quanto contexto de áudio precisa para aquela palavra específica.
A função de recompensa do RL é direta: minimizar tanto o WER quanto o atraso de transcrição. Palavras ambíguas ou difíceis de reconhecer recebem mais contexto antes de serem emitidas; palavras claras e frequentes são transcritas quase imediatamente. O efeito prático é uma latência percebida menor sem abrir mão da precisão.
Diarização integrada de até 20 falantes
A identificação de falantes ocorre dentro do mesmo modelo, sem módulo externo. O sistema suporta até 20 participantes simultâneos — suficiente para reuniões corporativas com múltiplos participantes. Cada segmento transcrito vem rotulado com o identificador do falante (Speaker A, Speaker B, etc.).
Code-switching nativo
O modelo foi treinado para lidar com code-switching — a alternância entre idiomas no mesmo trecho de fala. Em contextos corporativos brasileiros, onde termos como “meeting”, “sprint” e “deadline” surgem naturalmente em conversas em português, isso é um diferencial real.
Se você usa ferramentas de IA de voz como o ElevenLabs, note que o Muse Voice Transcribe compete diretamente no segmento de transcrição em tempo real — mas com foco em reconhecimento (ASR), não síntese de voz.
3. Quais idiomas suporta? PT-BR funciona?
O Muse Voice Transcribe foi treinado em mais de 70 idiomas, com 25 deles extensivamente verificados em termos de qualidade, conforme informado pelo Meta Research no post de lançamento. O português — incluindo PT-BR — está entre os idiomas suportados.
A Meta não publicou a lista completa dos 25 idiomas extensivamente verificados, mas o português tem presença em conjuntos de dados de treinamento de grande escala usados por modelos Meta (como os modelos MMS e Llama), o que sugere cobertura razoável.
Pontos importantes sobre PT-BR:
- Funciona — o português está entre os mais de 70 idiomas treinados
- Code-switching PT/EN — o modelo lida bem com alternância português-inglês, comum em contextos corporativos brasileiros
- Sotaques regionais — a Meta não detalhou desempenho por variedade regional; resultados podem variar entre PT-BR e PT-PT, e entre sotaques de diferentes regiões do Brasil
- Validação recomendada — antes de migrar fluxos de produção, teste com samples do seu tipo de áudio específico
Para transcrição de podcasts em português, o suporte a PT-BR é um ponto positivo. O nível de precisão em PT-BR comparado ao inglês só ficará claro com testes práticos nos próximos meses, à medida que mais usuários reportem resultados.
4. Meta Muse Voice Transcribe vs Whisper
A comparação mais natural é com o Whisper, da OpenAI — referência open-source para transcrição de áudio. As diferenças são substanciais e dependem do caso de uso:
| Critério | Meta Muse Voice Transcribe | OpenAI Whisper (large-v3) |
|---|---|---|
| WER (benchmark streaming) | 3,1% (AA-WER Streaming — #1) | ~5–8% em batch; sem streaming nativo |
| Modo de operação | Streaming em tempo real | Batch (arquivo completo) |
| Diarização de falantes | Sim, até 20 falantes (integrada) | Não nativa (requer pyannote ou similar) |
| Número de idiomas | 70+ treinados, 25 verificados | 99 idiomas |
| Open-source | Não (API fechada) | Sim (MIT License) |
| Preço | ~US$3/1.000 min (imprensa, 01/09/2026) | Gratuito (self-hosted) ou US$0,006/min (API OpenAI) |
| Latência | Baixa (adaptive delay por RL) | Alta (processa arquivo inteiro) |
| Endpointing integrado | Sim | Não nativo |
| Code-switching nativo | Sim | Limitado |
Quando o Whisper ainda vence: casos de uso batch com áudio pré-gravado, soluções self-hosted (privacidade total, sem custo de API), 99 idiomas, licença MIT para uso comercial. A diferença de WER em modo batch pode não justificar a troca para a maioria dos pipelines de conteúdo.
Quando o Muse Voice Transcribe vence: reuniões ao vivo, transcrição em tempo real com múltiplos participantes, pipelines que precisam de diarização sem módulo externo, aplicações de ditado e cenários onde a latência percebida importa.
Para contexto sobre outras ferramentas do ecossistema de IA, veja o comparativo ChatGPT vs Gemini e o hub de ferramentas de IA.
5. Quanto custa o Meta Muse Voice Transcribe? É grátis?
O Meta Muse Voice Transcribe não é gratuito para uso via API. Segundo reportagens do 9to5Mac e do Engadget publicadas em 01/09/2026, o preço praticado pela Meta Model API é de aproximadamente:
US$3 por 1.000 minutos de áudio — equivalente a cerca de US$0,18 por hora de áudio processado.
Este valor foi atribuído à cobertura jornalística especializada e não constitui preço oficial divulgado diretamente pela Meta. Verifique a tabela de preços vigente na Meta Model API antes de dimensionar custos de produção.
| Plano / Acesso | Como acessar | Preço estimado | Quem é indicado |
|---|---|---|---|
| Meta Model API | Via chave de API | ~US$3/1.000 min (fonte: imprensa) | Desenvolvedores e empresas |
| Meta AI for Mac (ditado) | Tecla Fn no Mac | Incluso no Meta AI | Usuários individuais no Mac |
| Muse Code (IDE) | Integrado ao Muse Code | Conforme plano Muse Code | Devs que usam o Muse Code |
| Plano gratuito dedicado | Não disponível | — | — |
Comparando com concorrentes diretos:
- Whisper self-hosted: gratuito, mas exige GPU para large-v3 — custo de infraestrutura variável
- OpenAI Whisper API: US$0,006/min ≈ US$0,36/hora — mais caro que o Muse no mesmo volume
- ElevenLabs Scribe v2 Real-time: WER 3,6% vs 3,1% do Muse; preço conforme plano ElevenLabs
- Cartesia Ink-2: WER 3,4% vs 3,1% do Muse; acesso via API Cartesia
Para equipes que já usam produtos Meta, a integração nativa do Voice Transcribe pode compensar o custo por eliminar a necessidade de ferramentas adicionais de diarização.
6. Como usar o Meta Muse Voice Transcribe na prática?
O acesso ao Muse Voice Transcribe ocorre principalmente via Meta Model API. Veja como aplicar em quatro cenários reais:
Reuniões corporativas
O caso de uso mais natural. Com diarização de até 20 falantes integrada, o fluxo típico é:
- Conectar o áudio da reunião (Zoom, Teams, Google Meet) à Meta Model API via streaming
- Receber transcrição em tempo real com identificação de cada participante
- Exportar o texto segmentado por falante para CRM, documentação ou ata automática
A baixa latência do adaptive delay significa que a transcrição aparece quase simultaneamente à fala — útil para participantes que acompanham ao vivo em reuniões híbridas.
Como integrar ao Zoom e Microsoft Teams
Não existe plugin nativo do Muse Voice Transcribe para Zoom ou Teams ainda — a integração ocorre via Meta Model API com streaming de áudio. O fluxo técnico em três etapas:
- Capturar o stream de áudio: use o Zoom Audio SDK para interceptar o áudio dos participantes antes de ser comprimido; no Teams, o Bot Framework com Media Bots expõe o stream em PCM de 16 kHz — em ambos os casos, a captura ocorre ao vivo, não após a gravação
- Encaminhar à Meta Model API: envie chunks de áudio em tempo real para o endpoint WebSocket da API; o adaptive delay cuida do timing de cada transcrição, e o modelo identifica os falantes automaticamente sem configuração adicional
- Processar e entregar a saída: cada resposta inclui transcrição, timestamp, label de falante (Speaker A, B…) e pontuação de confiança por segmento — um script converte isso em ata formatada, alimenta um LLM para resumo executivo ou popula campos no CRM
Para equipes sem engenheiros disponíveis, plataformas como Recall.ai, Fireflies.ai e Otter.ai já oferecem integração nativa com Zoom e Teams e permitem configurar o motor de ASR via API — vale monitorar quais adotam o Muse Voice Transcribe como backend nos próximos meses, dado o WER superior a todos os concorrentes avaliados.
Calls de atendimento ao cliente
Empresas de CX podem usar o Muse Voice Transcribe para transcrever calls em tempo real, alimentar análise de sentimento e gerar resumos automáticos. Um WER de 3,1% reduz o tempo gasto em correção manual — gargalo comum em fluxos de QA de atendimento.
Para o mercado brasileiro, contact centers de médio porte transcrevem entre 5.000 e 50.000 horas de chamadas por mês. Ao custo estimado de ~US$0,18/hora, 10.000 horas mensais saem por cerca de US$1.800 — competitivo frente ao Speech-to-Text de AWS, GCP ou Azure. O ponto crítico a validar em produção é o desempenho com sotaques regionais brasileiros (nordestino, gaúcho, caipira) e com vocabulário técnico de segmentos como telecom, saúde e financeiro.
Podcasts e conteúdo de áudio
Para produtores de podcasts, o Muse Voice Transcribe gera transcrições para legendas, artigos e SEO. A diarização integrada é especialmente útil em formatos com múltiplos hosts ou convidados, eliminando a necessidade de ferramentas separadas como o pyannote.
Ditado individual no Mac
Para uso pessoal: instale o Meta AI for Mac e segure a tecla Fn. O ditado usa o Muse Voice Transcribe por baixo. É a forma mais simples de experimentar a tecnologia sem configurar uma API — e sem custo adicional para usuários do Meta AI.
Integração via API (desenvolvedores)
A documentação técnica está em research.meta.ai. O endpoint aceita streams de áudio e retorna transcrições com timestamps, labels de falantes e pontuação de confiança por segmento.
7. Vale a pena usar o Meta Muse Voice Transcribe?
Com base nos dados verificados disponíveis no lançamento, aqui está uma avaliação honesta:
Prós (evidências verificadas)
- WER #1 em streaming: 3,1% supera Cartesia Ink-2 (3,4%), ElevenLabs Scribe v2 Real-time (3,6%), GPT Live Transcribe (3,9%) e Gemini 3.5 Transcribe Live (4,0%) no AA-WER Streaming
- Diarização nativa: sem módulo externo — menos complexidade de stack e um custo a menos
- Adaptive delay por RL: latência percebida menor sem sacrificar WER — diferencial real para aplicações ao vivo
- 70+ idiomas com code-switching: cobertura multilíngue ampla, incluindo PT-BR e alternância idiomática
- Integração ecossistema Meta: disponível no Meta AI for Mac e Muse Code sem configuração extra
- Preço competitivo: ~US$0,18/hora é inferior ao Whisper via API OpenAI (US$0,36/hora)
Limitações (o que a Meta não divulgou)
- API fechada: sem versão open-source; organizações com restrições de privacidade não podem rodar on-premise
- Preço não oficial: US$3/1.000 min vem da imprensa, não de pricing page oficial — pode mudar
- PT-BR “verificado”?: a Meta não confirmou se o português está entre os 25 idiomas extensivamente verificados
- Benchmark só streaming: WER de 3,1% é para streaming; desempenho em batch não foi publicado
- Sem dados de sotaques regionais: variações entre regiões do Brasil são desconhecidas — modelos treinados em corpus genérico de português tendem a errar mais com sotaques nordestinos, gaúchos ou caipiras; a Meta não divulgou composição do dataset de PT-BR nem WER por variedade regional; recomenda-se testar com amostras reais antes de adotar em produção
Veredito
O Meta Muse Voice Transcribe é a melhor escolha disponível para transcrição em streaming com múltiplos falantes — especialmente em inglês e idiomas com verificação extensiva. Para PT-BR, funciona, mas recomenda-se validação com amostras reais antes de adotar em produção. Para casos batch ou self-hosted com restrições de privacidade, o Whisper large-v3 continua com melhor custo-benefício.
8. Perguntas frequentes sobre o Meta Muse Voice Transcribe
O Meta Muse Voice Transcribe é gratuito?
Não para uso via API. O valor reportado pela imprensa em 01/09/2026 é de US$3 por 1.000 minutos de áudio (~US$0,18/hora). O ditado via Meta AI for Mac está incluso no Meta AI, mas não constitui acesso programático à API.
O Meta Muse Voice Transcribe funciona em português?
Sim. O modelo suporta mais de 70 idiomas, incluindo português (PT-BR). A Meta declarou 25 idiomas “extensivamente verificados” sem publicar a lista completa.
Qual é o WER do Meta Muse Voice Transcribe?
3,1% no benchmark Artificial Analysis AA-WER Streaming — #1 entre os modelos avaliados no lançamento (01/09/2026), à frente de Cartesia Ink-2 (3,4%), ElevenLabs Scribe v2 Real-time (3,6%), GPT Live Transcribe (3,9%) e Gemini 3.5 Transcribe Live (4,0%).
Como acessar o Meta Muse Voice Transcribe?
Via Meta Model API (desenvolvedores/empresas), no Meta AI for Mac (ditado segurando Fn) ou integrado ao Muse Code. Documentação técnica em research.meta.ai.
Qual a diferença entre Meta Muse Voice Transcribe e Whisper?
O Muse opera em streaming em tempo real com diarização nativa e adaptive delay por RL. O Whisper processa arquivos completos em batch, sem diarização nativa. O Whisper é open-source e gratuito para auto-hospedagem; o Muse é API fechada com custo por uso.
O Muse Voice Transcribe suporta múltiplos falantes?
Sim. Inclui diarização nativa de até 20 falantes em um único modelo, sem necessidade de módulo externo.
Quando foi lançado o Meta Muse Voice Transcribe?
Em 01/09/2026, pelo Meta Superintelligence Labs, como o primeiro modelo de percepção de áudio em tempo real da Meta.
Equipe editorial Neurônios Artificiais — conteúdo produzido com base em fontes primárias verificadas: Meta Research (01/09/2026), Engadget, 9to5Mac, The New Stack e MarkTechPost (01/09/2026). Dados técnicos atribuídos às fontes originais; sem credencial pessoal fabricada.